CS336 学习记录 02:Resource Accounting
第二节从浮点数、FLOPs 和 Roofline,一路算到反向传播、训练显存、梯度累积和 activation checkpointing。开头整理了一张公式速查卡和两道 napkin math 例题,正文保留推导过程。
第二节开始进入 resource accounting。这一讲几乎没有什么“新的模型结构”,反而一直在算:一个 tensor 占多少显存,一次矩阵乘法有多少 FLOPs,GPU 理论上能算多快,真实为什么又跑不到那个数字。
刚开始看 motivating questions 的时候我就觉得特别眼熟:
- 70B 模型训练 15T tokens,在 1024 张 H100 上要多久?
- 8 张 80GB H100,用 AdamW 最多能训练多大的模型?
这种题真的很像国内算法岗或者大模型训练岗面试里会出现的估算题。教授也直接把它叫做 back-of-the-envelope / napkin math:不追求一开始就把所有细节算到特别精确,而是先对资源量级有感觉。
下面先放一张速查卡,回来找公式时看这一节就够了;点每一行开头的名字会跳到正文里对应的推导。正文基本按课程顺序,从“一个数占几个 bytes”一路算到训练显存。
速查
公式卡
| 要算什么 | 公式 | 备注 |
|---|---|---|
| tensor 占多少显存 | 元素个数 × 每个元素的 bytes | FP32 4 bytes,BF16 / FP16 2 bytes,FP8 1 byte |
| 一次矩阵乘法 | : FLOPs | 每个 一次乘一次加 |
| 训练总计算量 | = 参数量, = 训练 token 数。前向 ,反向 ;长 context 下会低估 | |
| 训练时间 | MFU 能到 0.5 左右就算不错 | |
| 训练显存(AdamW 混合精度) | bytes + activations | 参数 2 + 梯度 2 + Adam 的 各 4(FP32) |
| 最多能训多大的模型 | 不含 activation,是上界。一张 80GB 卡大约 6.7B | |
| 算术强度 | bytes 要把读和写都算上 | |
| 硬件强度 | H100(BF16)约 295 FLOP/Byte | |
| 判断瓶颈 | 硬件强度 → memory-bound;反之 compute-bound | elementwise 基本都是 memory-bound,大 matmul 是 compute-bound |
| Roofline 下的 MFU 上限 | 只算单个操作、计算和搬运完全重叠的理想情况 | |
| Gradient accumulation | effective batch = micro batch × accumulation steps | 只降低峰值 activation 显存;参数、梯度、optimizer states 不变 |
| Activation checkpointing | 每隔 层存一个 checkpoint | activation 显存 ,额外重算 |
napkin 例题
70B 模型训练 15T tokens,1024 张 H100 要多久? 课件的算法是先用 算总量,再除以整个集群每天的有效算力(H100 BF16 dense 峰值 989.5 TFLOP/s,MFU 取 0.5):
也就是差不多 5 个月。
8 张 80GB H100,用 AdamW 最多能训练多大的模型? 每个参数按 12 bytes 算:
大约 53B。课件特意说明这里没算 activation(它取决于 batch size 和 sequence length),所以这是一个上界,真实能训的模型会更小。
硬件数字
以下数字都来自课程源码:
| 硬件 / 量级 | 数字 |
|---|---|
| H100 BF16 | 989.5 TFLOP/s(spec 上的 1979 是带 sparsity 的数字,dense 要除以 2) |
| H100 FP32 | 67.5 TFLOP/s |
| H100 显存 | 80 GB,带宽 3.35 TB/s |
| A100 BF16 / FP32 | 312 / 19.5 TFLOP/s |
| 8 张 H100 跑两周 | 约 FLOPs(按峰值算) |
| GPT-3 训练 | FLOPs |
| GPT-4 训练 | 据推测约 FLOPs |
浮点格式
一个 tensor 的显存 = 元素个数 × 每个元素的 bytes。 后者由 dtype 决定:FP32 是 4 bytes,FP16 / BF16 是 2 bytes,FP8 是 1 byte。课件举的例子是 GPT-3 feedforward 层里的一个 矩阵,用 FP32 存就要约 2.3 GB。
FP32、FP16、BF16 这些名字以前当然见过,但这次比较完整地把它们和范围、精度、显存占用放到一起看。浮点数本质上就是二进制科学计数法:
sign 决定正负,exponent 决定动态范围,fraction / mantissa 决定精度。
FP32 有 8 bit exponent 和 23 bit fraction;FP16 把 exponent 缩到 5 bit,所以动态范围明显变小。像课上直接演示的 ,转成 FP16 就会 underflow 到 0。BF16 则保留了和 FP32 一样的 8 bit exponent,只把 fraction 压到 7 bit,所以动态范围基本没问题,代价是分辨率变粗。
这个 trade-off 我现在会这样记:
FP16:精度还行,但动态范围容易出问题
BF16:动态范围够大,但小数细节比较粗
FP32:稳,但显存和计算都更贵
所以实际训练会用 mixed precision。课里的典型配置是:
parameters / activations / gradients -> BF16
optimizer states                    -> FP32
这里以前我只知道“混合精度能省显存、加速”,现在更能理解为什么 optimizer state 倾向保留 FP32:AdamW 的一阶、二阶动量会长期累计很小的变化,对数值精度更敏感。后面算训练显存时的“每个参数 12 bytes”,就是从这套配置来的。
再往下是 FP8。H100 支持两种 FP8:E4M3 的范围是 ,E5M2 是 ,一个用更多 bit 换精度,一个用更多 bit 换范围。
FP4 与共享 scale
FP8 之后又讲到了 NVFP4。4 bit 一共就 16 种编码,E2M1 能表示的基础数值非常粗:
以及对应的负数。
一开始看这个范围会觉得很离谱:参数和 activation 怎么可能只在这么几个值之间选?
关键在于 FP4 不再只靠单个 4-bit value 表示真实数量级,而是让一小块数共享额外的 scale。可以把它想成:
于是 4 bit 本体负责“局部相对大小”,scale 负责“这一小块整体是什么数量级”。
代价也很明显:同一个 block 里的数共享 scale,如果邻居之间量级差得太大,outlier 会把 scale 拉大,小数值就更容易被量化掉。这里让我第一次比较具体地感觉到,低精度不是简单地“少几个 bit”,而是需要额外的表示设计才能真的拿来训练。课件也提到 Nemotron 3 Super 已经是用 NVFP4 训练的。
einops
einops 不是新算法,而是让 tensor 操作从“第几个维度”变成“这个维度是什么”。
比如以前写:
z = x @ y.transpose(-2, -1)脑子里还得先想 -2、-1 分别是什么。einops 可以直接写:
z = einsum(
    x, y,
    "batch seq1 hidden, batch seq2 hidden -> batch seq1 seq2"
)
这里一眼就能看出:两个输入在 hidden 维上相乘并求和(输出里没出现的维度会被求和),输出保留 batch seq1 seq2。
reduce 更适合单个 tensor 上做 sum / mean / max 之类的 reduction;rearrange 则可以显式拆、合维度。例如:
rearrange(x, "... (heads hidden) -> ... heads hidden", heads=2)如果原来最后一维长度是 8,就会按 拆成 heads=2, hidden=4。Transformer 里经常要在 和 之间来回切,这种写法确实比一串 view + transpose + permute 更不容易看错。
FLOPs 计数
乘 的矩阵乘法大约是 FLOPs;把 看成 token 数、 看成参数量,forward 就是 。
一次浮点加法或者乘法通常都记作 1 FLOP。点积:
有 次乘法和 次加法,所以严格来说是 ,做大规模估算时直接近似成 。
如果 ,,那么 里每个 组合都有一次乘法和一次加法,大约需要:
FLOPs。
课件里有一句我觉得挺关键: 可以看成 data points / tokens,而 就是这一层的参数量。所以 forward pass 可以先粗略理解为:
这就是上一节见过的 的雏形。后面把 backward 也数完以后,这个 6 才真正落下来。以前 看起来比较像一个需要记住的经验式,现在终于能看到,它就是从一个个矩阵乘法的乘加操作数出来的。
课上还有同学问到 Strassen 之类 sub-cubic matrix multiplication。老师的回答也挺符合这门课的风格:理论上当然存在渐近复杂度更低的矩阵乘法算法,但真实大模型系统里的优化通常更关心 tiling、memory hierarchy、Tensor Core、kernel、并行和通信这些 system 问题。也就是不一定把 改成 ,而是想办法让这个 真正在 GPU 上跑得接近硬件峰值。
FLOP/s 与 MFU
FLOPs 是做了多少运算,FLOP/s 是每秒能做多少;MFU 是实际 FLOP/s 占硬件峰值的比例,0.5 左右就算不错。
这两个缩写读音一样,很容易混:
- FLOPs:做了多少浮点运算,衡量工作量;
- FLOP/s:每秒能做多少浮点运算,衡量硬件速度。
显卡 spec 里的 FLOP/s 必须先问一个问题:
什么 data type?
同一张卡在 FP32、BF16、FP8 下的峰值差别很大;是否使用 Tensor Core、是否把 sparsity 算进去,也会影响宣传数字。H100 spec 上的 1979 TFLOP/s 是带 sparsity 的,课件算 dense BF16 时直接除以 2,用 989.5 TFLOP/s;FP32 只有 67.5 TFLOP/s。
我自己平时常用学校的 A100,又会拿笔记本 3060 跑一些小东西,所以这里开始有了一点量级感。A100 的 BF16 Tensor Core 是 312 TFLOP/s,FP32 只有 19.5 TFLOP/s。以后再看到“某卡有多少 TFLOPS”,不能只拿一个数字横着比。
有了实际 FLOP/s 和峰值,就可以算 Model FLOPs Utilization(MFU,模型 FLOPs 利用率):
我现在更愿意把 MFU 理解成:这张 GPU 的理论计算能力,有多少最终转成了模型真正需要的数学计算。
易混点:课件定义里写着“ignore communication / overhead”,不是说通信和 overhead 不影响性能,而是它们不算进分子的有效 model FLOPs。通信、同步、kernel launch、数据搬运、等待其他 GPU 这些事情都会占时间,于是最后 MFU 会掉下来。
CUDA 计时
GPU 默认很多操作是异步提交的。Python 执行:
a @ b不一定会停在那里等 GPU 真算完,而是把任务提交到 CUDA stream 后继续往下走。所以 benchmark 前后要:
torch.cuda.synchronize()否则测到的可能只是 CPU 把任务扔给 GPU 花了多久,而不是 GPU 真正完成 matmul 的时间。这个细节以前写训练代码基本不会主动想,但做性能分析时就完全不能忽略。
算术强度
算术强度 = 每搬 1 Byte 数据做多少 FLOPs。它低于硬件的“算力 / 带宽比”就是 memory-bound,高于就是 compute-bound。 MFU 为什么到不了 1,很大一部分原因就在这里。
单位是 FLOP/Byte。算 bytes 的时候要把读取和写回都算上。例如 BF16 ReLU,每个元素:
read x   -> 2 bytes
write y  -> 2 bytes
compute  -> roughly 1 operation
所以:
GELU 每个元素可以粗略按 20 FLOPs 算,算术强度是 ,比 ReLU 高不少,但依然很低。也就是说这些 elementwise operation 单独执行时,GPU 往往不是缺计算能力,而是在等数据。课件的说法是:单独执行时 ReLU 并不比 GELU 快,因为两者都卡在搬运上。
易混点:算术强度不是“计算占总时间的比例”,而是每搬 1 Byte 数据,能做多少次浮点运算。读和写的 bytes 都要算,漏掉写回会把 ReLU 的算术强度高估一倍。
硬件强度
课件把硬件这一侧叫 accelerator intensity。我之后在国内交流里会更倾向叫它 硬件算力/带宽比,Roofline 里也常对应 ridge point(屋脊点):
H100 在 BF16 口径下是 FLOP/Byte。于是判断 bottleneck 就很直接:
我自己的直觉就是:如果硬件每搬 1 Byte 理论上能做将近 300 FLOPs,但这个算法每搬 1 Byte 只安排了 0.25 FLOP,那显然算力是“吃不饱”的,瓶颈就在 memory bandwidth。
batch size 与利用率
老师接着分别算了几种操作的 arithmetic intensity(BF16, 左右):
| 操作 | 计算量 | 搬运量 | 算术强度 | H100 上 |
|---|---|---|---|---|
| ReLU | 0.25 | memory-bound | ||
| GELU | 5 | memory-bound | ||
| dot product | 约 0.5 | memory-bound | ||
| matrix-vector product | 约 1 | memory-bound | ||
| matrix-matrix product | 约 | compute-bound |
matrix-vector multiplication 里,计算和大矩阵的搬运大致还是同一量级,算术强度很低;到了 matrix-matrix multiplication,数据搬运还是 ,计算却涨到 ,同一批数据被重复利用了很多次,算术强度就会随着矩阵规模增长。 时约 341,已经超过 H100 的 295。
这里我第一次特别直观地理解了 batch size 和 GPU 利用率的关系。单个样本做线性层更像 ,是 matrix-vector product;但如果一次把很多样本 / token 堆起来变成 ,就是大 GEMM。同一份权重矩阵从 HBM 搬进来以后,可以服务很多个 token,搬运成本被更多计算摊薄,于是算术强度提高,也更容易把 Tensor Core 喂满。
这也顺便解释了老师对 inference 的预告:autoregressive decode 每一步生成的 token 很少,小 batch 下大量线性层更接近 matrix-vector / skinny matrix multiplication,所以经常是 memory-bandwidth-bound;训练和 prefill 一次处理很多 token,更容易形成大 GEMM,因此更容易 compute-bound。
Roofline
到这里 Roofline Model 基本就是前面所有概念的汇总。
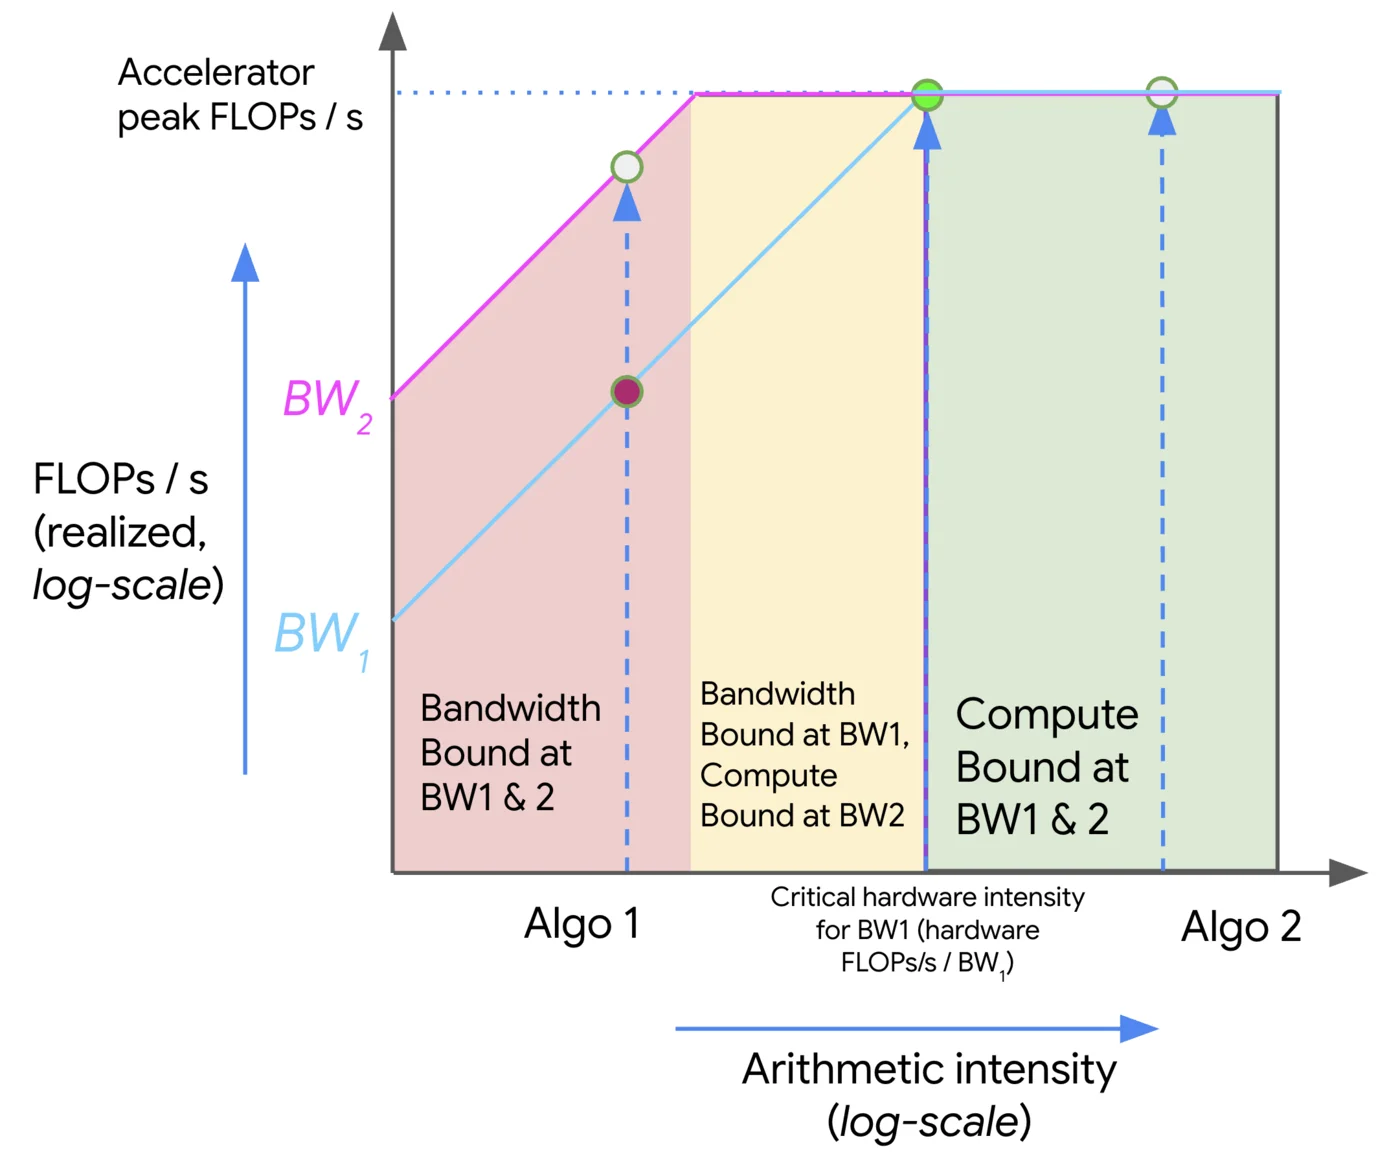
Roofline Model。CS336 Lecture 2 直接引用了这张 JAX Scaling Book 图。
它对应的核心关系是:
左边算术强度比较低时,,提高显存带宽或者提高数据复用,都可能让性能继续往上涨。到了拐点以后,计算单元已经吃满,再增加 arithmetic intensity 也无法突破硬件 peak FLOP/s,于是进入 compute-bound 区域。拐点的横坐标就是上面的硬件强度。
两边同时除以 peak FLOP/s,就回到了 MFU。课件最后把它写成:
这是单个操作、计算和搬运能完美重叠时的上限;真实训练里还有通信和各种 overhead,只会更低。
图里同时画了两个 bandwidth,也让我意识到一个以前比较容易忽略的点:
memory-bound / compute-bound 不是算法自身一个绝对不变的标签,而是 workload 和 hardware 的关系。
同一个算法,在带宽比较低的硬件上可能 memory-bound,换成更高带宽的硬件以后就可能碰到 compute ceiling。
反向传播与 6ND
每个线性层的 backward 要做两次和 forward 同量级的 GEMM,所以 forward 、backward ,合起来是 。
课件用一个两层线性网络来数。看第二层:
如果每个样本是一行,那么这一层 forward 的计算量大约是 。
反向时需要做两件事。第一件是把梯度继续传给前一层:
第二件是算当前权重自己的梯度:
这两项本质上又各是一次同量级的 GEMM,所以 backward 大约是:
也就是 forward 的两倍。对整个网络的所有参数都这样数一遍:
forward:   2 × (# data points) × (# parameters)
backward:  4 × (# data points) × (# parameters)
total:     6 × (# data points) × (# parameters)
这里顺便把反向传播最核心的逻辑重新捡了一遍:weight gradient 是为了更新当前层参数;hidden gradient 本身不是要被优化,而是为了继续往前传播,让更前面的层能算出自己的 weight gradient。到了最原始输入,如果它本身不是可训练变量,一般也就没必要继续算 input gradient 了。
这两个公式我准备直接留着当回忆:
课件还特意强调,这个近似对 short context Transformer 也很好。原因是 Transformer 里大部分参数和计算也在 Q/K/V projection、attention output projection、MLP projection 这些线性层里;但 attention 还有 的 和 。context 很长以后,这个二次项就不能继续忽略, 也会越来越不准。
易混点:我这里把符号搞混了一次。这个 toy MLP 里, 是 data points, 是 hidden dimension,所以一层的参数量大约是 ,总计算量是 。而 scaling law 常写的 里, 通常是参数量, 才是训练 token 数。也就是说更准确的对应是:
B              <-> D_scaling(token / data 数)
D_hidden^2     <-> N_scaling(参数量)
所以以后最好直接在脑子里把 翻译成“6 × parameters × tokens”,而不是只记字母。
训练显存
AdamW 混合精度训练时,每个参数约 12 bytes:参数 2 + 梯度 2 + optimizer states 8。activation 另算,随 batch size 和 sequence length 增长。
对于一个 层、每层 的 toy network,batch size 为 ,训练显存主要可以分成四类:
| 内容 | 为什么要存 | 这个例子里的开销 |
|---|---|---|
| Parameters | 模型权重本身 | BF16: bytes |
| Activations | backward 时需要 forward 的中间结果 | BF16: bytes |
| Gradients | 每个参数对应一个梯度 | BF16: bytes |
| Optimizer states | 保存历史梯度统计 | AdaGrad:;Adam: bytes |
Adam 对每个参数要保存一阶矩 和二阶矩 ,通常都用 FP32,所以单 optimizer states 就是 bytes/parameter。在这套简化假设下,如果先不算 activation,Adam 训练一个参数至少就要:
这就是开头那道“8 张 80GB H100 能装多大模型”的答案来源:。反过来也可以记成一张 80GB 卡大约能放下 6.7B 参数的训练状态。
对比一下推理:不算梯度、不需要 optimizer states,activation 也只需要保留当前层的(不用为 backward 存下所有层),所以主要就是 BF16 参数的 bytes。
老师还强调了一个很有用的区分:memory capacity 决定能不能 fit,memory bandwidth 和 compute 才直接决定跑得多快。 也就是说,单纯从 40GB 换成 80GB,如果模型和 batch 原本已经能完整放进 40GB,而且算力、带宽都一样,并不会因为容量翻倍就直接跑快一倍。但容量会间接限制 batch size、checkpointing、offload、并行方式,所以最后还是可能影响实际吞吐。
至于真正的 Transformer,课件说账更复杂但思路一样,留给 Assignment 1 自己算。
易混点:老师先用一句很紧凑的路线把几个经典 optimizer 串起来:
SGD + gradient 的指数平均         -> Momentum
SGD + 累积 gradient^2             -> AdaGrad
AdaGrad + gradient^2 改成指数平均 -> RMSProp
RMSProp + gradient 的指数平均     -> Adam
我一开始甚至把这四句看成了“四种开销”,后来才发现它只是在快速回顾 optimizer 的演化关系。和显存有关的只是最后一步:AdaGrad 每个参数存一个量(4 bytes),Adam 存两个(8 bytes)。
另外视频画面里有一处变量名写法会让人以为又乘了一次 byte;官方源码里 gradient memory 是 2 * num_parameters,AdaGrad state 是 4 * num_parameters。这种 resource accounting 最稳的办法还是顺手检查一下单位:现在乘的是“参数个数”,还是已经算好的“bytes”。
用计算换显存
两种方法都是多花计算、少占显存:gradient accumulation 减少一次同时处理的样本数,activation checkpointing 减少同一个 micro-batch 里长期保存的中间 activation。
Gradient accumulation
大 batch 往往更稳定,也更容易形成大的 GEMM,但 activation memory 会随着 batch size 增长。如果想要 effective batch size = 1024,而显存一次只能塞 256 个样本,就可以拆成 4 个 micro-batch:
256 -> forward/backward -> 累积 gradient,不更新
256 -> forward/backward -> 继续累积
256 -> forward/backward -> 继续累积
256 -> forward/backward -> 继续累积
                         -> optimizer.step()
                         -> zero_grad()
所以:
这里就是:
如果 loss 的 reduction 和 scaling 处理一致,那么把四个 micro-batch 的梯度求和再平均,和一次真正对 1024 个样本求平均梯度在理想条件下可以数学等价。
它真正省掉的是峰值 activation memory:同一时刻只需要保留 256 个样本的 activation,而不是 1024 个。parameters、parameter gradients 和 optimizer states 并不会因此变小。总 FLOPs 也没有凭空减少,实际还可能因为更多 kernel launch 稍微慢一点。
Activation checkpointing
Activation Checkpointing 也常叫 gradient checkpointing 或 rematerialization。正常训练为了 backward,会把每一层的 activation 都存下来;checkpointing 则只保留一部分 checkpoint,backward 需要中间 activation 时,就从最近的 checkpoint 重新 forward 算一遍。
课件里最简单的版本是每一层都作为 checkpoint:只存每个 block 的输出 ,block 内部的中间结果(比如 ReLU 之前的那个值)在 backward 时重算。它已经能省下一部分显存,但 activation 还是随层数 线性增长。
每隔 √L 层存一次
再进一步,假设有 层,每隔 层保存一个 checkpoint。长期保存的 checkpoint 大约有 个;而 backward 重算当前 segment 时,这一段最多还要临时保留大约 个 activation。所以峰值 activation memory 可以粗略写成:
这里两项都是 memory:前者是全局 checkpoint,后者是当前重算 segment 的临时 activation,并不是把 memory 和 compute 加在一起。让两项平衡,,得到 ,于是峰值 activation memory 是 。同时每个 segment 只需要额外重算一次,总 recomputation 仍然是 。
三种策略放在一起:
| 策略 | activation 显存 | 额外计算 |
|---|---|---|
| 全部 activation 都存 | 几乎没有 | |
| 每隔 层存一个 | ||
| 什么都不存,每层都从头重算 |
易混点:“0 个 checkpoint”的 memory 和上面的分段公式并不是同一种执行策略。如果只是不存 checkpoint、然后 backward 前完整重算一次并把整段 activation 暂存下来,峰值显存仍然会回到 ;要做到真正的 ,就得为每一层的 backward 都从最开始重新算到那里,代价才会涨到 。
小结
第二节学完以后,感觉它真正想训练的不是背某个公式,而是看到一段训练代码以后,先主动问几件事:
- tensor 有哪些:parameters、gradients、activations、optimizer states、data;
- 这些 tensor 各自是什么 dtype,占多少 bytes;
- 主要运算有多少 FLOPs,真实 FLOP/s 离硬件 peak 多远;
- arithmetic intensity 多高,到底是 compute-bound 还是 memory-bound;
- 如果模型或 batch fit 不下,是减小 micro-batch、做 checkpointing,还是换并行和 offload 策略。
这样再看课程最后那几条 summary 就顺很多了: data points parameters 是 compute 的粗账;Roofline 是判断速度瓶颈;gradient accumulation 和 activation checkpointing 则是在显存不够时重新安排“存”和“算”的关系。