DDA5001 HW2 复习笔记:从 Softmax 到过拟合
从分类分数和训练误差讲起,重新推一遍交叉熵梯度、Legendre 回归与样本外误差,再用实际热力图理解过拟合。
做这次作业时,我有几个地方反复停下来确认。平面上的四个点有一种标记能被直线分开,为什么还不能说它们被打散?交叉熵明明定义在概率上,为什么代码能跳过概率直接算?最后画热力图,为什么训练标签一点噪声都没有,十次模型还是可能更差?
如果已经忘得差不多,可以先扫一眼速查,再从卡住的地方往下读。每段都从题目给了什么开始。
速查
| 要找什么 | 先记住哪一步 |
|---|---|
| VC 维度 | 固定点的位置,试遍所有标签。带截距的 维线性分类器的 VC 维度为 。 |
| 测试误差 | 测试误差是独立测试集上的平均,样本外误差是对真实分布取期望。 |
| 梯度下降 | 沿负梯度走,小步可以下降,大步可能跨过谷底。 |
| Softmax 与交叉熵 | 全体分数减去同一个常数,概率不变。单样本损失是 。 |
| 分类梯度 | 对 logits 的梯度是 。代码把样本放在行上,梯度是 。 |
| 三种更新 | GD 和 Momentum 在当前位置算梯度,Nesterov 在外推点算梯度。 |
| 多项式回归 | 每个输入先变成一行基函数值,然后用 least squares 拟合系数。 |
| 解析样本外误差 | 对齐两组系数,缺项补零。系数差 的贡献是 。 |
| 过拟合热力图 | 红色表示十次模型的平均样本外误差更大。黑线表示平均差为零。 |
VC 维度
Problem 1 先问二分类模型的表达能力。二维的 affine linear classifier(仿射线性分类器)用一条直线分开正负标签,直线可以平移,所以包含截距 。Shatter(打散)的测试是固定一组点,换遍它们的 种标签,每次都允许重新选一条直线。
三个不共线的点可以打散。三点同类时把直线放在三角形外,一点和另外两点异类时把那个顶点切出来。四点如果围成凸四边形,就给对角上的两点同一个标签。两组点各自连成的线段相交,直线无法把两组放在两侧。如果一点在另外三点的三角形内,就让内点单独为正。包含三角形三个顶点的半平面也包含内点。如果有三点共线,让中间点和两端异类即可。
做题时我想到把四边形沿周边标成 ,这确实可能分开。卡住的地方在“任意标签”这四个字。证明某组点无法打散,只要找到一种分不开的标签。
高维版也可以从这张图想起。 个仿射无关的点能让仿射函数分别取任意指定的 或 。而任取 个点,增广向量 必有线性依赖。把依赖式里正系数和负系数移到两侧,再各自除以系数之和,得到两组点的凸组合落在同一个位置。给这两组相反标签就无法分开,所以三维的答案是四。
测试误差
先固定已经训练好的模型。Out-of-sample error(样本外误差)问的是再从真实分布抽一个样本,平均会损失多少。Test error(测试误差)用一份独立测试集的实际平均值来估计它。同一个模型换一份测试集,估计值可能变化。训练误差用过模型拟合的那批数据,第三题会用到它和样本外误差的区别。
梯度下降
凸函数(convex function)的图像在任意两点的连线下方或与连线重合。对于可微凸函数,切平面是整个函数的下界,因此梯度为零时,该点就是全局最小点。开口朝下的抛物线是凹函数,顶点是最大点。
GD(gradient descent,梯度下降)用 更新。梯度指向上升方向,减号负责转向下降。以 、起点 为例,梯度是 。学习率 走到 ,损失从 变成 。学习率 走到 ,损失变成 。所以凸性和一步是否下降是两回事。梯度非零时,沿负梯度的方向导数是 ,足够小的正步长会下降。更新量很小只说明 小,曲面很平或者学习率很小也会有这种现象。
Softmax 与交叉熵
Problem 2 的多分类逻辑回归先给每一类一个分数 ,再用 softmax 把分数变成概率。这里 score 和 logit 都指 softmax 的输入。。分数最大的一类概率也最大。所有分数加同一个数,指数里的共同因子会约掉。乘同一个正数会保留排序,但通常会改变概率。
训练时用 表示真实标签的 one-hot vector(独热向量),用 表示预测概率。真实类别为 时,交叉熵 只剩 。比如正确类概率从 掉到 ,即使两次都猜错,损失也从约 涨到 。这就是为什么交叉熵和准确率可能给出不同的排名。
代码里可以先把每个样本的最大分数减掉,记 。把 softmax 代入交叉熵后得到
我当时卡在“怎么忽然能用 logits 算损失了”。把分式代进去展开对数就能看出来,等式两边是同一个量。对于 logits 且真实类别是第二类,直接算 可能先舍入到零。上面的式子先留下 ,即使 舍入到零,损失仍然是有限的 。
分类梯度
想更新类别 的参数,先求损失对它的分数 的导数。 出现在所有类别共享的分母里,因此每个 都可能变化。对 求导时只取交叉熵的第 项,得到 。再沿 softmax 传回去:
当 时,分子和分母都在变,结果是 。当 时只有分母变,结果是 。乘上前一步并求和,
因为 ,再乘一个 就得到单样本对该类权重的梯度。若 写成列向量,把所有类放在一起是 。实际代码中 是 ,一行一个样本,参数 是 ,一列一个类别。于是 是 的 logits, 是 的平均梯度。这里 是特征数, 是类别数, 是样本数。
三种更新
记 为梯度, 为上一步位移。把题目的三种方法放在一起看,区别主要在用哪个位置的梯度。
| 方法 | 一步怎么走 |
|---|---|
| GD | 。 |
| Momentum(动量) | 在 GD 的一步上加 。 |
| Nesterov | 先算 ,再从 走 。 |
可以把 Nesterov 的外推点当作“沿惯性先看一眼”。如果外推到了谷底另一侧,那里的梯度可能已经反向,这次更新就会往回修正。 是题目给定的调度系数。代码里用中心差分检查梯度,再用简单的 验证两种加速方法在哪里取梯度、更新后到了哪里。
跑完 1,000 步后,Digits 上 Nesterov 的测试准确率是 ,但测试交叉熵约 ,高于 Momentum 的 。Nesterov 的测试损失约在第 185 步达到最低,之后训练损失继续下降,测试损失却回升。Dry Bean 的结果不同,Nesterov 最终训练和测试损失都是三种方法中最低的。这里比较的是两份数据上的实测曲线。
多项式回归
Problem 3 改做回归。题目先生成一个真实函数 ,抽出 个均匀分布在 的输入。训练标签是 ,其中 是标准正态噪声,所以噪声方差是 。二次和十次模型用同一批输入和标签拟合。
题目给的 Legendre polynomials(勒让德多项式)是一组基函数。前三项是 、、。输入一个 ,算出各个 ,就是这一行特征。比如 时,二次模型那一行是 。模型 对输入可以是弯的,对待学习的系数 仍然是线性的。
把 行堆成 ,形状是 。最小化 ,令梯度 为零,得到正规方程 。
解为什么唯一?如果有非零 使 ,那么 在每个训练输入上都为零。取最高一个非零系数,它的最高次项无法被低次项抵消,所以 是次数至多 的非零多项式。 个不同输入会给它至少 个不同的根,矛盾。于是 满列秩, 对非零 成立,正规方程有唯一解。
实现用 np.linalg.lstsq(X, y, rcond=None)[0] 求系数。rcond=None 使用 NumPy 的默认数值秩阈值。[0] 取的是返回元组里的整组系数。一次传入 的 labels 时,每列是一组独立拟合任务,共享同一个 ,返回的每列也是一组权重。
解析样本外误差
这里的 是预测与干净目标 的平均平方差。输入均匀落在长度为 的区间上,密度就是 ,所以取期望等于 。
先把两个函数写进同一组基。目标次数记为 ,题目把目标的整组随机系数除以归一化因子 ,因此目标系数为 。这种缩放让跨随机目标和输入的平均平方值为 。实现收到的 已经缩放过。对齐到 ,缺的项补零。比如模型只有二次,目标还有三次项时,。
题目直接给出 Legendre 基的 orthogonality(正交性)。可以把两个函数相乘再积分想成向量点积的连续版。不同下标的乘积积分为零,同一下标的平方积分为 。因此
交叉项是在积分后消掉的。分母的 来自基函数的平方积分,分子上的 刚好与均匀密度的 抵消。如果误差函数恰好是 ,结果就是 。代码因此只需要系数。实验前用已知的无噪声二次多项式检查系数恢复,再用数值积分核对解析误差,两者的差在 量级。
过拟合热力图
十次模型包含二次模型,因此最优训练误差不会更大。每个格子做 1,000 次模拟,颜色表示 的算术平均。红色表示十次模型在样本外更差,蓝色表示更好。黑线是平均差为零的等高线。超过 的格子颜色会饱和,计算均值时仍保留原始数值。
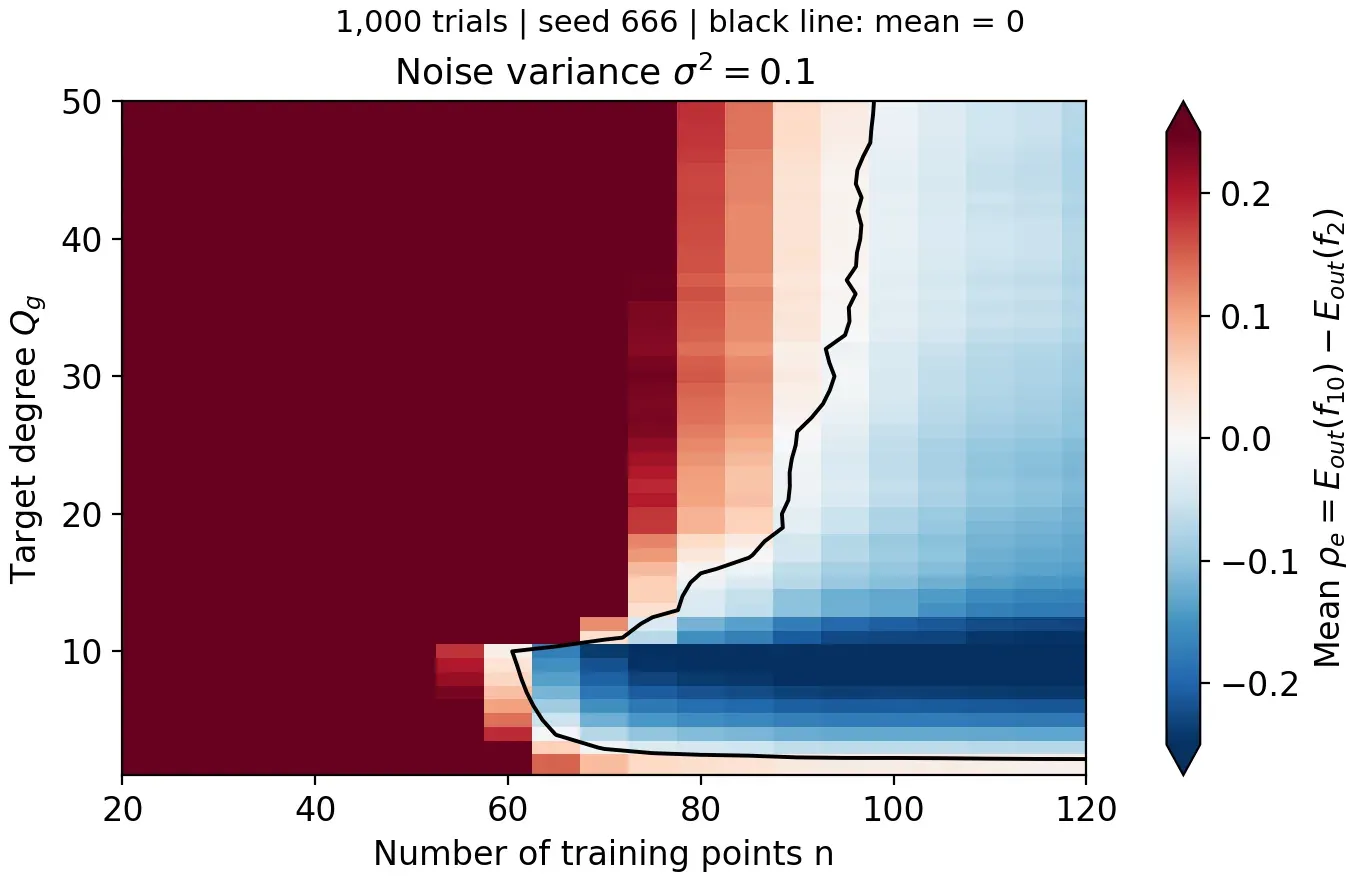
横着读,固定真实函数次数 ,训练点从 增到 ,平均差从 变到 。少量训练点对曲线的约束弱,十次曲线可以在训练点上贴得很好,在采样稀疏的地方却偏得很远。
竖着读,固定 。当 或 时,二次模型已经能表达整个目标。到 时,十次模型能表达二次模型够不到的那些项,平均差降到约 。我当时看到再往上蓝色变浅,想到十次模型也开始跟不上了。更准确地读是两者的误差差距缩小了。两种模型都缺少十次以上的项,而且改变 时归一化也会缩放已有项。图上只有差值,读不出两边各自涨了多少。
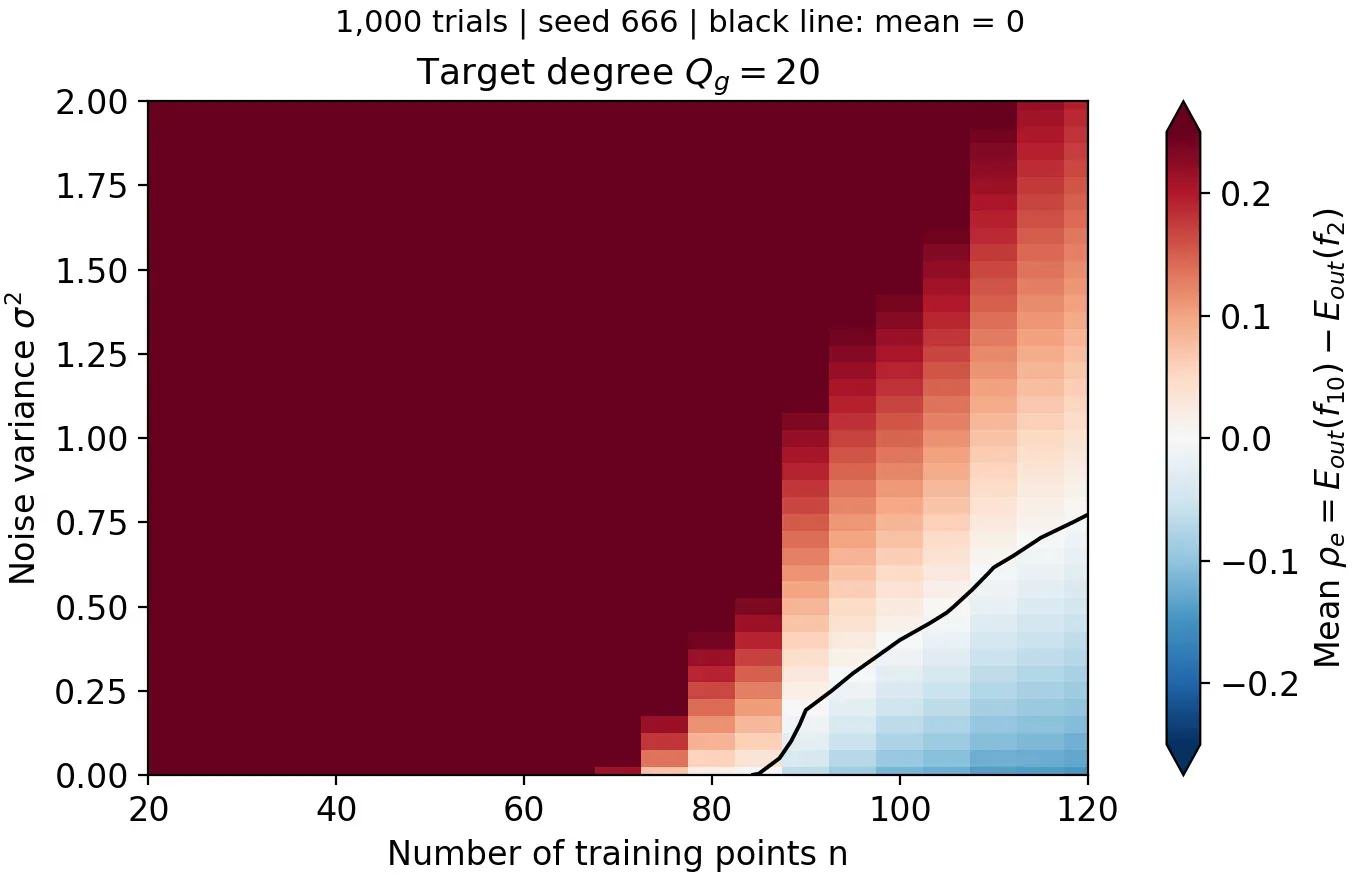
在 那一列,噪声方差从 增到 ,平均差从 升到 。数据少时,连底部 也有红色。比如 时平均差约 。我当时想到的是数据点不够。这里真实函数是二十次,十次模型本来也表达不全。即使标签完全准确,少量随机选中的点仍可能让十次模型得到一条在别处偏差很大的曲线。这个例子可以用来记住,无观测噪声时也可能出现相对于二次模型的过拟合。
合上笔记再试一次
- 四个点围成凸四边形,给出一种直线分不开的标签。解释为什么一种就够。
- 真实类的 logit 是 ,另一类是 。不先算概率,直接用稳定公式算损失。
- 模型没有 ,目标的 系数为 。它对样本外误差贡献多少?
可以先口头答一遍再核对。第一题把两个对角顶点标成正类,两条对角线相交。第二题是 。第三题的系数差是 ,平方后除以 ,得到 。